登录社区云,与社区用户共同成长
邀请您加入社区
暂无图片
为遵守国家网络实名制规定,未绑定将限制内容发布与互动
GaussDB 505.2+推出的ugin索引支持ustore引擎的模糊查询(如LIKE '%新年快乐%'),但依赖字符序。默认C字符序下,中文被当作字节处理,无法正确识别,导致查询仍走全表扫描;而使用zh_CN.utf8或en_US.utf8等基于字符的UTF-8排序规则时,ugin索引可生效,实现高效模糊搜索。注意:短于三字符的模式(如'%新年%')仍无法利用索引。建议建库时指定LC_COLL
GaussDB 505.2版本引入Ustore的ugin索引,支持like模糊查询高效检索,但实测发现其对中文模糊搜索支持不佳,尤其纯中文匹配时无法命中索引,导致全表扫描。Astore的gin索引在集中式与分布式环境下均有效,且对中文支持良好。尽管ugin索引使用简便,但中文场景下仍建议优先采用Astore gin索引以保障性能。
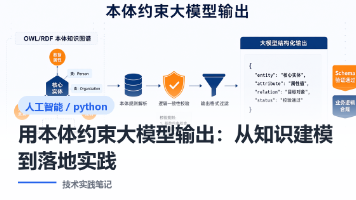
大模型在垂直领域落地时,经常出现术语混淆、关系编造、输出结构不稳定的问题。本文从本体建模出发,讲清楚如何用 OWL/RDF 定义领域概念与关系,再通过结构化提示、输出校验和 GraphRAG 检索,把本体约束注入到 LLM 的生成流程中。文中给出可运行的 Python 示例,涉及 rdflib、pyshacl、langchain 等库,并说明各方案的适用边界与我没验证过的部分。
当团队需要大规模调用大模型接口,开发者会面临两种路线:基于 One-API、New-API、LiteLLM 搭建自建中转网关,或者直接采购成熟商业 API 中转站服务。很多团队简单认为自建等于省钱,但忽略服务器、运维、账号风控、网络维护等隐性成本。本文从成本构成、人力投入、风险点、适用场景多角度对比两条路线,帮助技术负责人做出更贴合团队现状的架构决策。选型不要陷入"自建就省钱,采购就是交智商税"的
本次通过华为云码道 Agent 辅助开发了一个基于 HiveQL 的学生成绩统计分析项目,实现了学生人数统计、平均分计算、及格率分析、成绩等级划分和专业分组统计等功能。整个过程让我感受到,AI 编程助手不仅能够生成单段代码,也可以围绕一个完整的开发目标,协助创建项目文件、组织 SQL、准备测试数据和编写验证工具。对于 Hive 这类以数据处理为核心的技术,使用码道 Agent 可以让基础实验的开发
这一篇最值钱的东西不是那 32 微米,而是两件事:一是把覆盖从 4 组扩到 20 组这个动作本身。四组的时候世界一片美好,二十组的时候m12差一千万米还全绿。如果我只满足于"它测试通过了",这个 bug 会跟着代码进生产。扩覆盖的成本是两轮码道加一次解析器,很便宜。二是**"打印"和"断言"不是一回事**。我第一轮收到"逐组误差打印"时居然觉得挺满意——它把数字都给我看了呀。但没人看的东西等于没测
端到端 26/28 能扫 ← 本来是对的我的闭式判分 0/16 ← 诬陷按判分改完,判分 16/16 ← 全绿端到端 1/28 ← 产品坏了裁决实验:我们 == 第三方 ← 错的是判分器三层判分确实救了场,但它救场的方式和我预想的相反:不是"多一层就能抓到 AI 的 bug",而是多一层就会多一个出错的地方,而那个地方可能是你自己。所以这一篇留给我的规矩只有两条,都很朴素:其一,任何"新加的一层"
当你能把题目变成一道有标准答案的客观题时,AI 的产出才第一次变得可评价。而一旦开始评价,最先被审判的其实是裁判自己。这一路我给自己的裁判改了五轮(时间级联、隐式钉死条件、BYSETPOS 覆盖整个周期、空数组真值、冲刷时机),给差分台改了两次口径(无解规则不算分歧、锚点没覆盖的语义不算越权判决),最后还发现"0 分歧"这句话被我的随机生成器悄悄削弱了——它结构上产不出空数组,而空数组上两边真的会
国庆高速免费规则仅看驶离出口时间,与上高速时间无关。临近截止时“就近下高速等过0时再上”可省全程已行驶里程费用,且省钱金额与剩余里程无关。本文通过纯逻辑引擎+25项断言验证,发现真实场景中决策窗口极短(仅几十分钟),晚于0时则无法省钱。工具跑出3个关键bug,均在实测中暴露,最终生成零权限、纯离线、免安装的鸿蒙元服务,拒绝“加速赶路”选项,确保用户理性决策。
频率保持 440 Hz、音量保持 60%,依次切换正弦波、三角波和方波。正弦波主要集中在基频附近;换成三角波、方波以后,基频之外出现了更明显的奇次谐波,方波的高次谐波尤其容易看到。图8:频率和音量设置相同,切换波形观察谐波分布。440 Hz 表示基频,声音里还可能有其他频率成分。它们的强弱不同,听起来就会有不同的音色。另外,同一个音量设置下,不同波形的主观响度也可能不同;这次只固定了滑杆数值,并没