登录社区云,与社区用户共同成长
邀请您加入社区
由于没有那么多机器,就在自己的虚拟机上部署一套hadoop集群,这被称作伪分布式集群,但是不管怎么样,这里主要记录部署hadoop的过程以及遇到的问题,然后再使用一个简单的程序测试环境。1、安装JAVA、下载hadoop程序包,配置hadoop的环境变量。 这里要设置JAVA_HOME为java的安装目录,将hadoop程序所在的目录添加到系统的PATH环境变量下,这样可以直接在s
云计算研究领域:【1】体系结构【2】云安全【3】云监测【4】数据管理【5】资源管理调度【6】云计算编程【7】云支撑平台【8】云计算应用(科学/商业)【9】虚拟化【10】Inter-cloud 协议【11】云计算标准【12】联合云(Federation of clouds)【13】网格与云计算【14】节能管理(Energy-Efficient)
创建虚拟机,搭建hadoop集群(一台主机两台从机)1.在VMware Workstation Pro里创建一台虚拟机,经过一些简单的虚拟机配置,对CentOS系统进行安装,一开始选择语言,软件以及分区(不进行任何设置),加装桌面、系统管理工具,方便集群可视化,设置密码,完成后进行安装:2.接受协议,重启系统3.设置密码:*********普通用户:lindff4.重启后,需要选择本机语言,地区时
一、下载Hadoop安装包二、安装Hadoop三、配置环境变量四、为Hadoop用户授权五、格式化HDFS文件系统六、拍摄快照保存配置好的虚拟机七、启动和关闭HDFS集群
一、概述前些日子开始着手高校云平台的搭建,其中涉及很重要的一部分是hadoop集群测试环境的安装与配置,大概用了两天的时间,终于搞定了基本轮廓,把我的经验分享给大家。二、硬件环境1、windows 7 旗舰版 64位2、VMware Workstation ACE 版 6.0.23、Redhat Linux 54、Hadoop-1.2.0WindowsVM虚拟机...
CDH这里目录标题CDH1、 平台介绍1.2. CDH提供2、CDH结构图3、 Cloudera Manager3.1.CloudraManager技术构成3.2. CM 功能5、CDH 6.3.2 安装部署5.1. 环境准备5.1.1. 虚拟机前置配置5.1.2. 虚拟机新增配置5.1.3. Mysql数据库5.1.4. 上传安装包5.1.5. 安装Httpd5.1.6. 制作本地Yum源5.2
centos6安装cdh1. 离线包的准备1. 下载虚拟机镜像2. 安装Oracle的JDK3. cm下载4. CDH文件下载2. 开始搭建1. **修改主机名和修改IP和主机的对应关系(**所有节点**)**a.**修改主机名**b.**修改IP和主机的对应关系**2.**打通所有节点的ssh**(所有节点执行):a.检查服务sshd是否有开启b.生成密钥c.注册其他机器d.检查是否都可以免密登
Hadoop入门Hadoop运行环境搭建(开发重点)3.1 虚拟机环境准备3.2 安装JDK3.3 安装Hadoop3.4 Hadoop目录结构第4章 Hadoop运行模式4.1 本地运行模式4.1.1 官方Grep案例4.1.2 官方WordCount案例4.2 伪分布式运行模式4.2.1 启动HDFS并运行MapReduce程序4.2.2 YARN上运行MapReduce 程序4.2.3 配置
2009年,一些新兴的开源公司需要引起人们的注意,他们不再局限在传统的领域,而是开始渗透进虚拟化、云计算等新兴领域。1 公司名称:Cfengine成立时间:2008年在挪威奥斯陆注册,2009年6月在美国注册。地点:奥斯陆,挪威,圣彼得堡,佛罗里达州公司产品:Cfengine 3(社区版),着重进行服务器配置管理。Cfengine Nova(商业版),用于服务器生命周期管理软件
hadoop2.6环境搭建1,准备环境:虚拟机hadoop01,修改ip地址master (192.168.111.10)slaves1(192.168.111.11) slave2192.168.111.12) 2,修改主机名字sudo gedit /etc/hostname(三个主机都要该)一、安装jdk(1.7) 注意:jdk版本必须要和系统
虚拟机上安装1、将spark-3.1.2-bin-hadoop3.2.zip安装包传到download2、解压 tar -zxvf spark-3.1.2-bin-hadoop3.2.zip -C /opt/software/3、改名:mv spark-3.1.2-bin-hadoop3.2 spark3124、进入:cd conf5、改名:mv spark-env.sh.template spa
在企业中非常关心每天从Java后台拉取过来的数据,需要多久能上传到集群?消费者关心多久能从HDFS上拉取需要的数据?为了搞清楚HDFS的读写性能,生产环境上非常需要对集群进行压测。HDFS的读写性能主要受网络和磁盘影响比较大。为了方便测试,将hadoop102、hadoop103、hadoop104虚拟机网络都设置为100mbps。100Mbps单位是bit;10M/s单位是byte ; 1byt
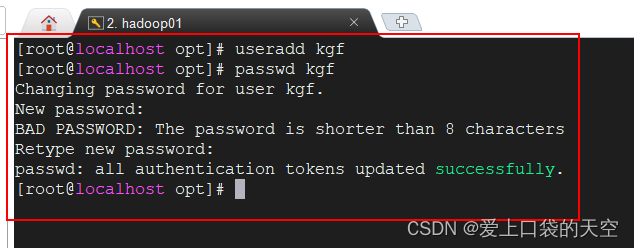
hadoop1004G50G不会装模板机vim:编辑器注意:在企业开发时,通常单个服务器的防火墙时关闭的。公司整体对外会设置非常安全的防火墙注意:kgf这一行不要直接放到root行下面,因为所有用户都属于wheel组,你先配置了kgf具有免密功能,但是程序执行到%wheel行时,该功能又被覆盖回需要密码。所以kgf要放到%wheel这行下面。。注意:如果你的虚拟机是最小化安装不需要执行这一步。
安装Ubuntu server准备条件创建虚拟机配置Ubuntu网络及相关功能准备条件1.准备条件:VMware及Ubuntu ISO镜像VMware workstation下载链接Ubuntu下载链接下面是下载后的Ubuntu镜像文件:创建虚拟机1.点击创建新的虚拟机2.勾选典型然后点击下一步3.点击浏览并打开Ubuntu所在的文件夹4.添加完镜像后点击下一步5.配置相关的虚拟机信息并点击下一步
文章目录1、事前准备 资源下载2、准备好虚拟机,安装JDK3、安装hadoop启动hadoop1、事前准备 资源下载提取码: tw6j2、准备好虚拟机,安装JDK创建虚拟机创建完虚拟机之后可以使用first.sh脚本执行一些基本设置#!/bin/bash#创建虚拟机之后需要做的一些事情#关防火墙systemctl stop firewalldsystemctl disable firewalld#
大数据自学——之Hadoop集群搭建分布式安装小白超详细安装教程小蜡笔的安装工具:VMwara(以管理员身份运行哦)、Xshell、Xftp**一、准备工作:***1.虚拟机安装三台linux 本次测试是 Centos 6.5,(三台虚拟机的系统时间保持一致) 安装第一台虚拟机,并将该虚拟机默认设为主节点,小蜡笔命名为:mast
要想深入的学习hadoop数据分析技术,首要的任务是必须要将hadoop集群环境搭建起来,可以将hadoop简化地想象成一个小软件,通过在各个物理节点上安装这个小软件,然后将其运行起来,就是一个hadoop分布式集群了。说来简单,但是应该怎么做呢?不急,本文的主要目的就是让新手看了之后也能够亲自动手实施这些过程。由于本人资金不充裕,只能通过虚拟机来实施模拟集群环境,虽然说是虚机模拟,但是在
hadoop伪分布式集群搭建(二、jdk,hadoop安装)前提一、安装jdk,配置jdk环境变量二、安装hadoop,配置hadoop环境变量前提hadoop伪分布式集群搭建(一、虚拟机安装)中的操作已经完成。在家目录下创建目录sudo mkdir /home/hadoop/softwares一、安装jdk,配置jdk环境变量解压jdk到指定路径sudo tar -vxf /mnt/hgfs/s
前言搭建一个HDFS集群,用了3台虚拟机,1台虚拟机是node1作为NameNode节点;3台虚拟机(另外两台虚拟机分别为node2,node3)分别启动DataNode节点,详情参考Hadoop集群环境搭建。1. 问题描述HDFS集群搭建并启动成功,一个NameNode节点和三个DataNode节点也运行正常,可以在各自虚拟机中jps命令查看正在运行的Java进程,但是在HDFS集群关闭之后,使
文章目录一、概念1. Hadoop是什么2. Hadoop优势(4高)3. Hadoop组成1)HDFS架构概述2)YARN架构概述3)MapReduce架构概述4)HDFS、YARN、MapReduce三者关系二、安装1. 前提条件2. 准备模板虚拟机3. 目录结构4. 分发命令与脚本配置1)scp(secure copy)安全拷贝a. 基本语法b. 例子2)rsync远程同步工具a. 基本语法
虚拟机栈 : 保存每个 Java 方法调用状态。
每个结点创建一个用户, adduser **这里 我们创建 4个 用户 四台 虚拟机的账号统一为 ID : hadoop
本文来源:中国农业银行软件开发中心官方微信公众号(我们的开心)文/ 李鹏斐 李鹏近年来云计算、大数据、人工智能等技术逐渐成熟,物联网、边缘计算等技术也逐步发展,科技进步和创新应用不断提速...
1.上传安装包2.解压tar -zxf apache-flume-1.8.0-bin.tar.gz添加软连接ln -s apache-flume-1.8.0-bin flume3.配置java环境变量cd $FLUME_HOME/confmv flume-env.sh.template flume-env.sh------------------------------------------ex
本人使用的是Ubuntu系统:ubuntu-12.04-desktop-i386.iso和虚拟机VMwareworkstation-v9.0.1。搭建的hadoop和spark所需要准备的资料分别有:jdk-7u51-linux-i586.tar.gzhadoop-2.2.0.tar.gzscala-2.11.2.tgzspark-1.0.2-bin-hadoop2.tgz
一、Ubuntu安装本次实战使用的Linux版本为Ubuntu,关于Ubuntu的安装教程可以看我的另一篇博客:https://blog.csdn.net/weixin_39626452/article/details/84893799二、虚拟机克隆1、在关机状态下右键选择要复制的基础虚拟机。2、完整克隆和链接克隆的区别:完整克隆和链接克隆都可以从字面意思上来看出端倪,...
情景描述: 在VM虚拟机上,按照hadoop手册,搭建Single Node. 启动hadoop时 #./start-all.sh 报错: ####################################################### localhost: Unrecognized op
大数据开发入门:二、Centos8安装Hadoop一、新建WinSCP连接二、安装jdk上一篇:大数据开发入门:一、VMware15.5 Pro安装Centos8及系统设置(全步骤)一、新建WinSCP连接1.先下载WinSCP并安装version:5.13.2链接:https://pan.baidu.com/s/19L-wzw01vpoiJu1nsg55-Q提取码:bbaw2.在虚拟机中输入命令
spark-history(设置权限777),spark-jars文件夹。ln -s 源文件名 新文件名。ln -s 源文件名 新文件名。ln -s 源文件名 新文件名。链接hadoop中的文件。链接hadoop中的文件。上传jar到hdfs。链接hive中的文件。
如果按照我的流程走,是没有问题的,有问题可以讨论,看到会回复。这里使用的使ubuntu18.04,创建三个虚拟机。一、创建虚拟机用户名hadoop虚拟机名datanode1datanode2datanode3用户名 hadoop 密码 123二、安装必要软件获取root权限sudo passwd root 设置root密码sudo -s进入root状态sudo su 给与root权限安装vmwar
1 选择Mapper的数量 Hadoop处理大量小文件的性能比较逊色,主要由于生成的每个分片都是一整个文件,Map操作时只会处理很少的输入数据,但是会产生很多Map任务,每个Map任务的运行都包括产生、调度和结束时间,大量的Map任务会造成一定的性能损失。可以通过Java虚拟机(JVM)重用来解决这个问题。hadoop默认每个JVM只运行一个任务。使用JVM重用后,一个JVM可以
hadoop的单机、伪分布式、完全分布式环境搭建一、 HDFS分布式文件存储系统单机版部署1.安装2.启动集群二、伪分布式存储系统部署1.编辑配置文件2. 做本地免密3. 启动进程4. 访问网页进行测试5. 创建存储目录6.复制输出文件到本地文件系统三、完全分布式存储系统部署1.开启两个新的虚拟机server2、server32.编辑文件共享策略,指定hadoop用户3. 查看同步是否生效serv
GIS可谓是自己的老本行,自己好久没有接触这方面,但最近由于自己和研究分布式计算框架Hadoop,觉得之前做GIS平台完全可以和云计算技术结合起来,这样GIS功能有质的提升。之前老总提出SOA架构,这个是从软件结构进行提升。但是从用户的体验以及性能方面,我觉得分布式计算是不错的选择,GIS行业一直没有应用,包括之前我之前单位:国内领先GIS平台公司。GIS软件面对的是超大的地理数据,而分布式计算利
文章目录集群准备复制虚拟机修改配置文件hadoop-env.shcore-site.xmlhdfs-site.xmlyarn-env.shyarn-site.xmlmapred-site.xmlslaves时间同步集群准备准备3台客户机(关闭防火墙、静态ip,主机映射、主机名称),主机名称分别hadoop2,hadoop3,hadoop4安装jdk,配置环境变量(可以直接复制hadoop1虚拟机,
虚拟机搭建完全分布式文章目录虚拟机搭建完全分布式1. 主节点配置1.1 安装系统环境1.2 设置静态IP1.2.1 查看子网IP【VMWare15】1.2.2 查看MAC地址是否与eth0匹配1.2.3 root用户下修改【/etc/sysconfig/network-scripts/ifcfg-eth0】1.2.4 重启网络服务1.2.5 设置windows主机中的虚拟网卡VMnet81.2..
大家已经知道了VMnet1、VMnet8与VMnet0虚拟交换机的关系,用过VMware Workstation或者VMware Server的朋友可能会问:既然VMnet1、VMnet8是交换机,那连接到交换机的网卡(就是虚拟机中使用的网卡)应该是设置什么地址都行的,但为什么在VMware虚拟机中,网卡地址会被固定在192.168.0.0—192.168.255.255的范围呢?大家
本篇的阶段性目标为实现虚拟机redhat上的hadooop运行(自带的WordCount示例程序)1 建立输入目录: hadoop fs -mkdir input 2 建立输入文件: 在 /usr/local/hadoop/hadoop-0.20.2 上建立test 文件夹. 里面创建file1 ,file2 文件,分别写入若干个单词3 将创建的输入文件放入in
在centos虚拟机中,使用xshell对hive的表进行查询的基本操作以及实战练习
hadoop100重启后,将虚拟机关闭,在导航栏中有虚拟机,点击,会发现有克隆完整虚拟机点击,然后修改虚拟机名称为hadoop102、hadoop103、hadoop104分别克隆三台虚拟机。如果想简历SFTP连接也是可以的,创建一个File Tranform连接,选择SFTP,输入IP地址,左侧有小钥匙,同样利用用户名和密码的方式进行连接即可。选择terminal,然后输入连接名,下面通过IP地
虚拟机中安装CentOS 7
(涵盖从0开始虚拟机安装及网络配置)保姆式教学! 一步一步跟着走就可以
一、修改虚拟机的网络配置配置好如图所示后,进入NAT设置二、修改Windows的网络配置选择 更改适配器选项选择 第三个VM8选择协议版本4后 如图配置三、关闭防火墙1.进入虚拟机关闭防火墙防火墙状态查看systemctl status firewalld关闭防火墙systemctl stop firewalld防火墙开机不启动systemctl dis...
首先,本博客写给初学hadoop集群搭建的的自己,为以防今后自己忘记!!1.克隆系统本次的linux系统用的时centos7版本,虚拟机使用的是VMware Workstation 15.5克隆后的截图如下所示:(克隆系统比较简单,所以过程不与展示了)2.修改克隆的主机名称centos7 可以使用(hostnamectl set-host hadoop101)命令,使用该命令可以将主机...
拍摄快照带有静态ip,克隆三台虚拟机,一共四台虚拟机。也可以克隆两台虚拟机,一共三台虚拟机。以下用的是四台虚拟机。拍摄快照的步骤:右键—快照–拍摄快照克隆虚拟机点击右键----快照—快照管理修改静态ip每台虚拟机都要修改静态ip,不要忘了重启网络哦== *==重启网络的命令service network restart修改主机名字hostnamectl set-hostname bigdata10
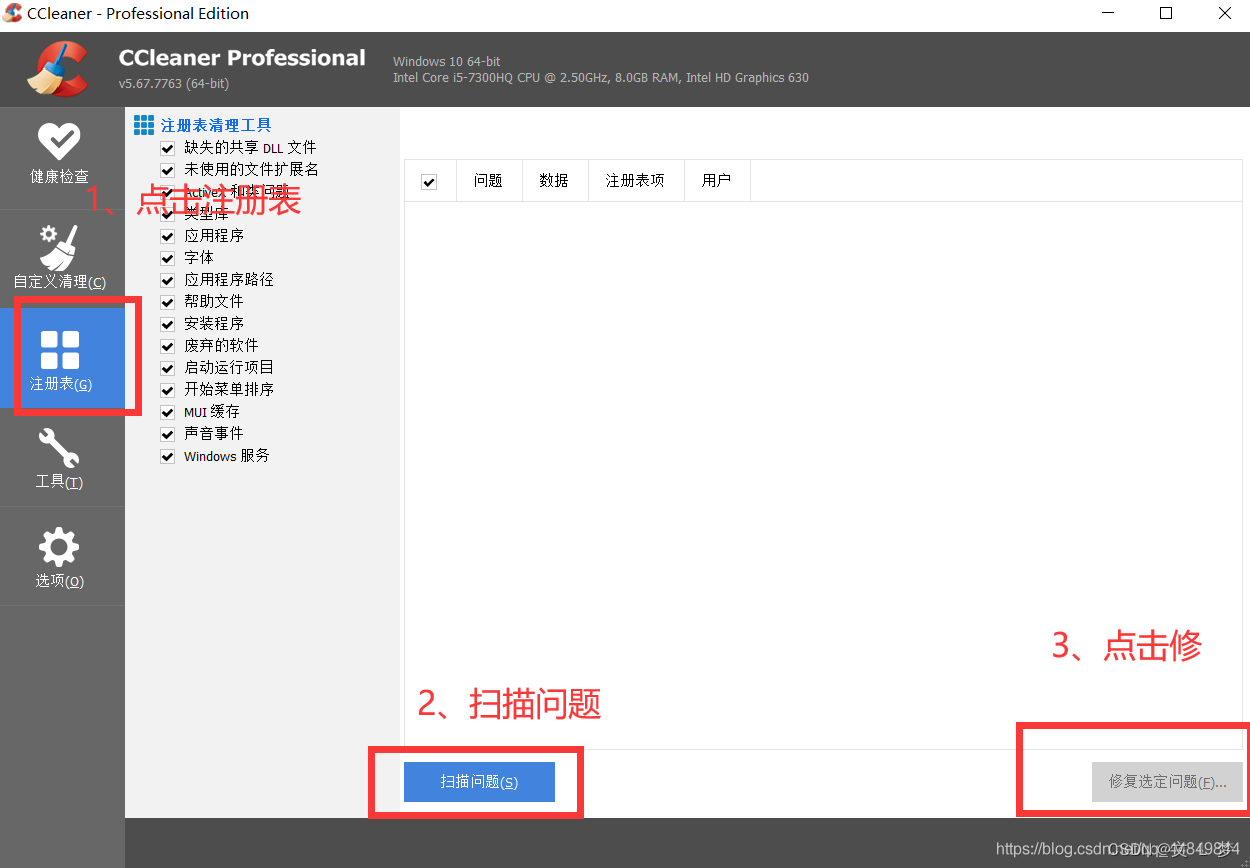
第一步:下载一个cclear下载链接:https://www.xitongqingli.com/xiazai.html。使用该工具将检测到的无效注册表清理掉,需要注意的是如果担心有风险,工具会提醒备份注册表。第二种:重装,我学着里的时候重装n次,慢慢就会了。第三步:更新完毕后进入主机网络适配器查看。将下面将下面箭头所指处选上,点击确定。打开虚拟机点击虚拟网络编辑器。方法一:(此方法最有效)
*2006年8月9日,谷歌首席执行官埃里克·施密特在搜索引擎大会上首次提出“云计算”(Cloud Computing)概念。2006年之前谷歌发表了3篇经典的论文,分别介绍了谷歌的分布式文件系统GFS、分布式数据存储系统BigTable和分布式计算框架(MapReduce)。分布式文件系统GFS谷歌文件系统简称为GFS,文件大小可以达到TB级,甚至是数百TB。Hadoop的文件系统HDFS正是借
Hadoop有三种分布模式:单机模式、伪分布、全分布模式,相比于其他两种,伪分布是最适合初学者开发学习使用的,可以了解Hadoop的运行原理,是最好的选择。接下来,就开始部署环境。首先要安装好Linux环境,可以是真机,也可以是虚拟机,我的环境是VMWare下安装的CentOS 6.3的虚拟机,如果你还没有安装好Linux环境,可以参考我的另一篇文章: window7环境下VMWare自定义安
工作中遇到了大数据方面的一些技术栈,没有退路可言,只能去学习掌握它,就像当初做爬虫一样(虽然很简单),在数据爆发的现在,传统的数据库mysql,oracle显然在处理大数据量级的数据时显得力不从心,所以有些特定的业务需要引进能够处理大数据量的数据库,hadoop提供了分布式文件系统(HDFS)来存储数据,又提供了分布式计算框架(mapreduce)来对这些数据进行处理,另一个hadoop的核心组件
有很多同学使用虚拟机无法通过 windows 和 Linux 共享复制粘贴板。实现起来可能比较麻烦,这里所给的代码是实验的测试代码。
本次搭建大概过程:配置linux环境安装jdk安装hadoop2.4.1配置ssh免登陆首先配置一台。在安装好所有的步骤之后,在可以备份扩展机date的时候,克隆一台母机备份。以便扩展(不能直接克隆dateNode机器稍加改造使用,否则会出现:你用该dateNode扩展的所有机器都只能被成功使用一台,其他的莫名其妙的就掉线)准备linux环境配置vm虚拟机点击VMware快捷方式,右